Par Mounib Mrani, Directeur Général d'Alton — octobre 2026
L'AIOps promet une informatique qui se surveille et se répare seule. La réalité est plus modeste et plus utile : l'IA trie le bruit des alertes, relie les incidents entre eux et aide les équipes à trouver la cause plus vite. Ce gain n'arrive que si la supervision est déjà organisée, et il se mesure. Avant d'acheter une plateforme, un comité de direction doit savoir ce qu'il en attend et à quel niveau d'automatisation il veut aller.
En bref
- La définition : l'AIOps applique l'IA et l'analyse avancée aux alertes et aux données de supervision pour accélérer, puis automatiser la réponse aux incidents. Gartner parle désormais de « solutions d'intelligence des événements », le terme AIOps étant devenu trop flou.
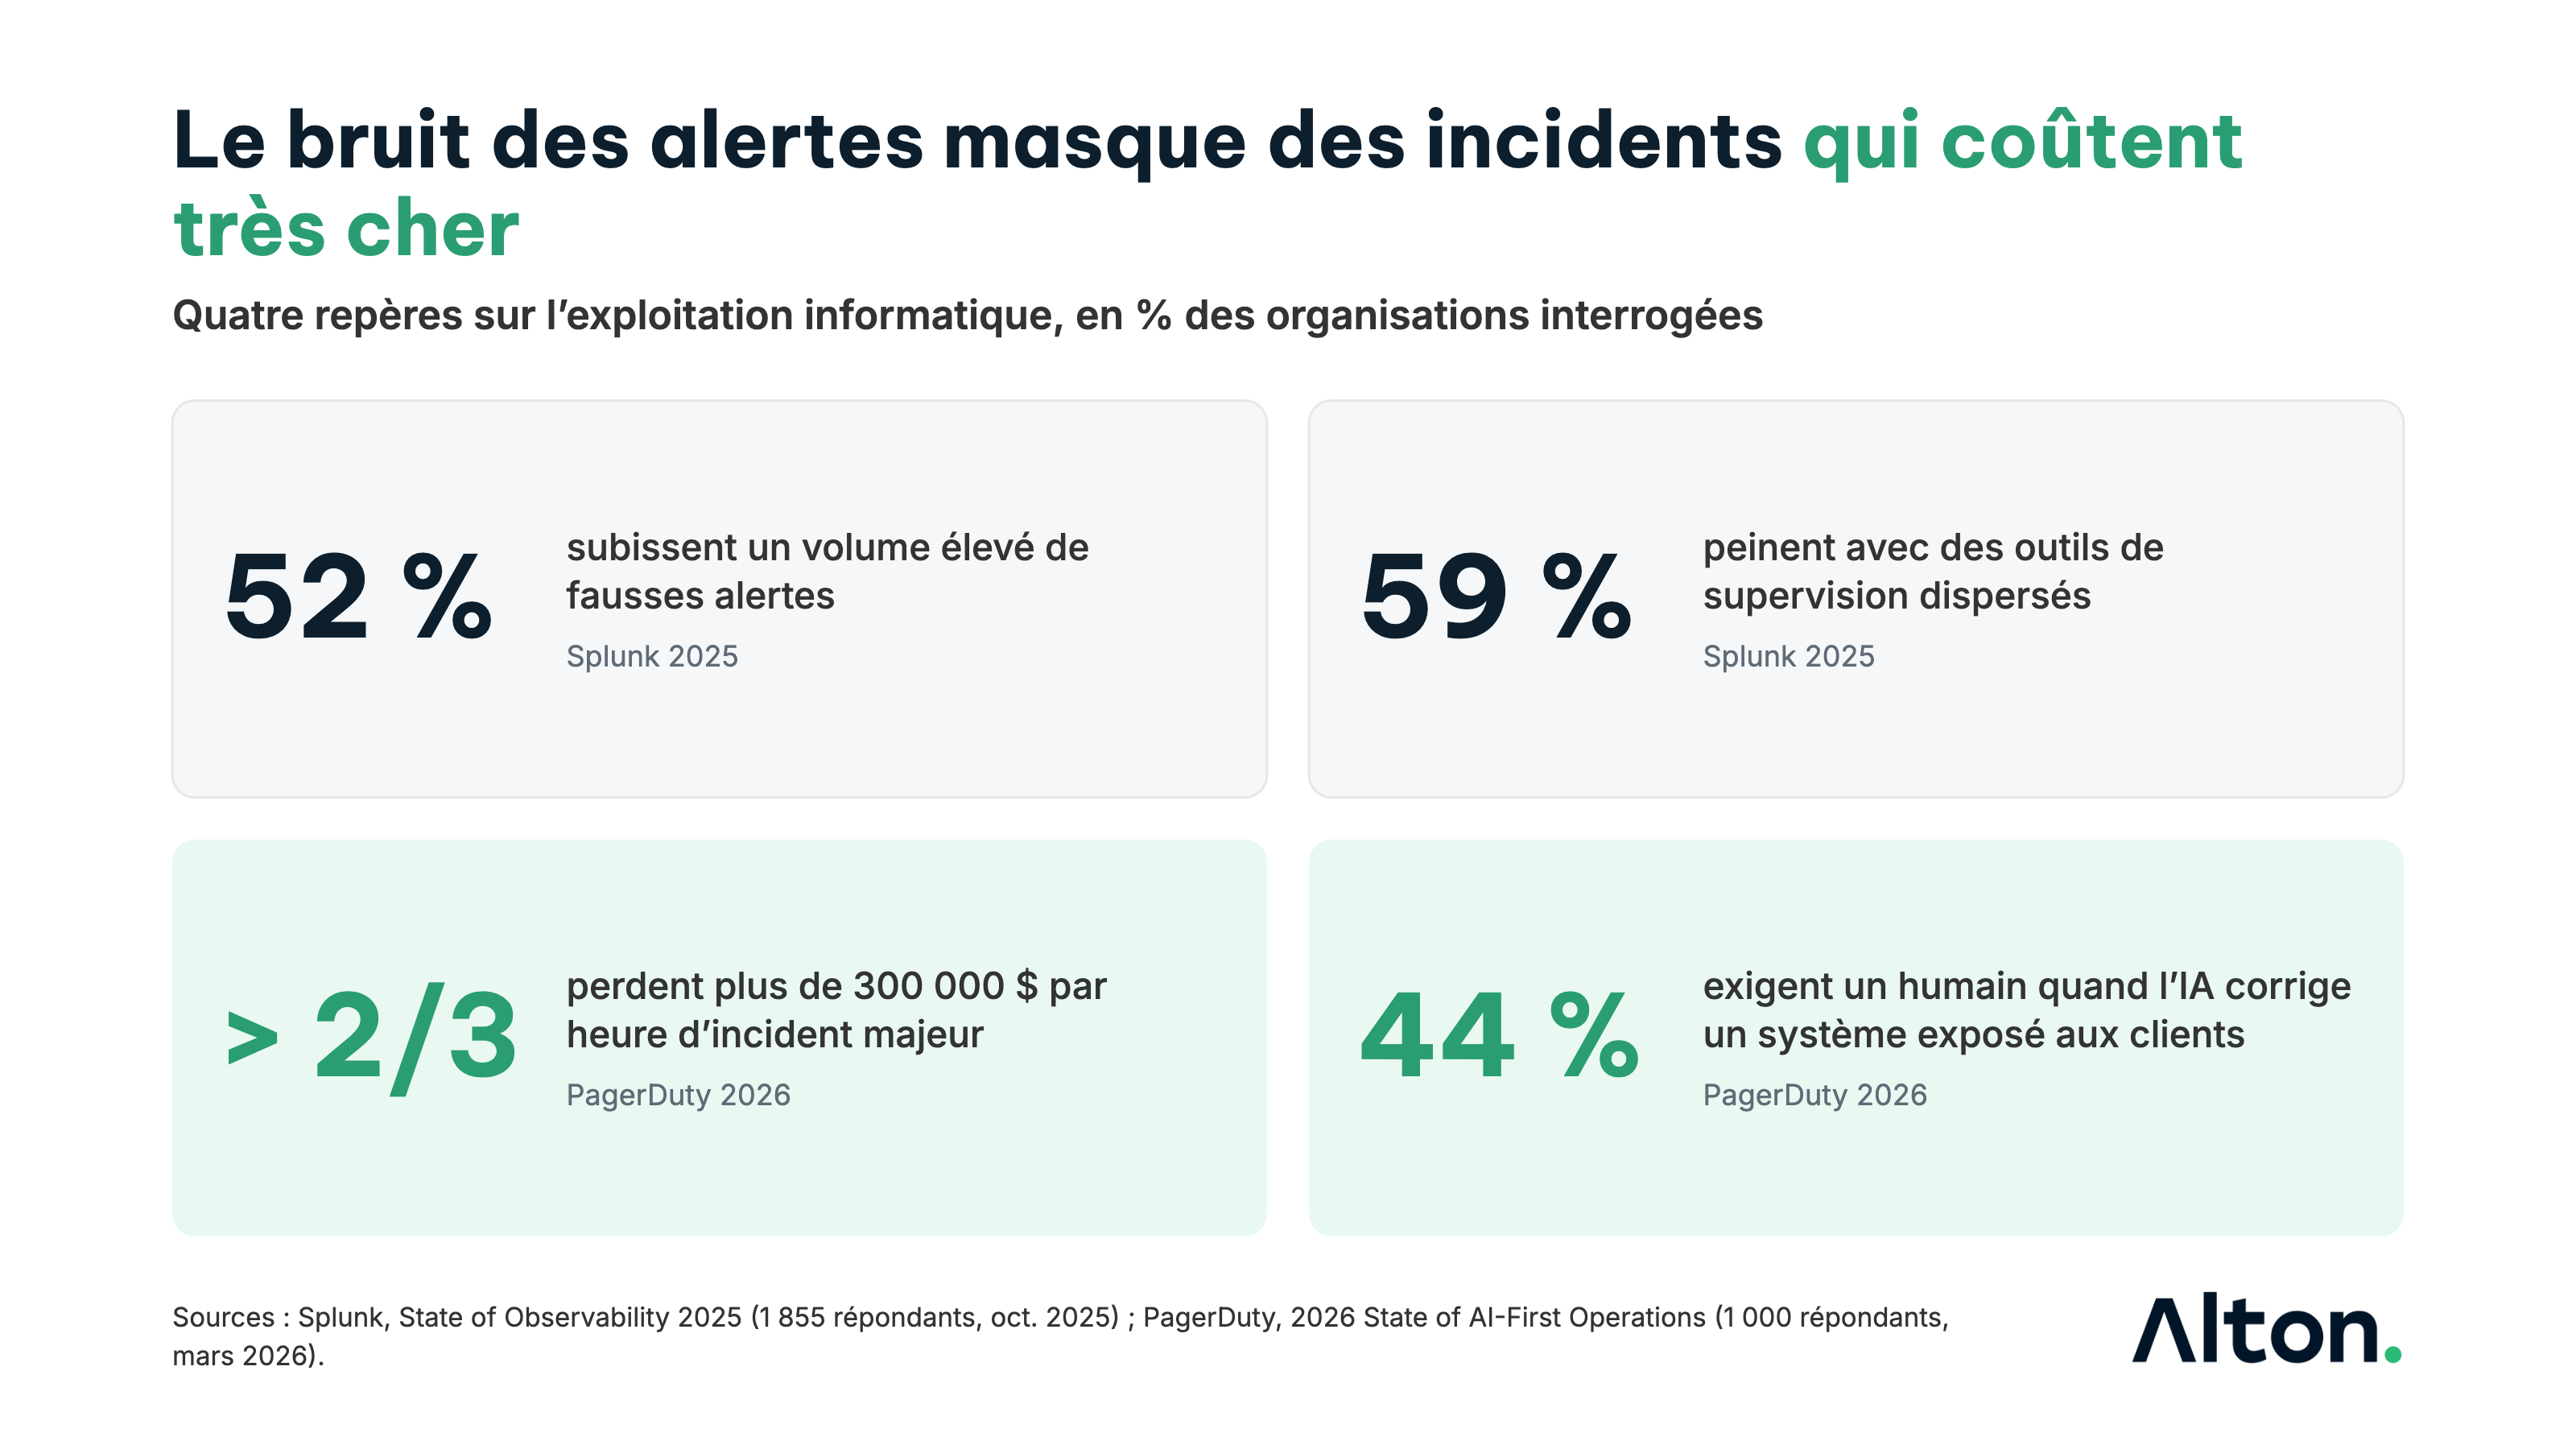
- Le problème à résoudre : selon Splunk (2025), 52 % des équipes subissent un volume élevé de fausses alertes et 59 % peinent avec des outils de supervision dispersés.
- L'enjeu financier : selon PagerDuty (2026), plus des deux tiers des organisations perdent plus de 300 000 dollars par heure lors d'un incident majeur.
- La limite : 44 % des organisations exigent une intervention humaine quand l'IA corrige un système exposé aux clients (PagerDuty, 2026). L'automatisation complète reste l'exception.
- La méthode : avancer par niveaux (collecter, corréler, contextualiser, recommander, automatiser) et mesurer quatre indicateurs à chaque étape.
Qu'est-ce que l'AIOps ?
L'AIOps, pour « intelligence artificielle appliquée aux opérations informatiques », désigne les outils qui analysent automatiquement les événements produits par la supervision : alertes, journaux, métriques, traces. Leur rôle est de transformer des milliers de signaux en un petit nombre d'incidents compréhensibles, d'en proposer la cause probable et, dans certains cas, de déclencher la correction.
Dans son guide de marché publié en mars 2025, Gartner a choisi de parler de « solutions d'intelligence des événements » (event intelligence solutions). Le cabinet constate que le terme AIOps a été repris par les éditeurs de nombreux marchés sans définition claire, ce qui créait de la confusion. Il recentre donc le marché sur des usages précis. Gartner retient cinq capacités clés :
- corréler et regrouper les événements venant de plusieurs outils ;
- réduire les notifications inutiles ;
- enrichir le contexte : services touchés, dépendances, responsables, priorité ;
- résumer les incidents en langage naturel grâce à l'IA générative ;
- s'intégrer aux autres outils d'exploitation : base de configuration, outil de gestion des services, outils d'automatisation.
Pourquoi le sujet remonte au comité de direction
Trois données récentes l'expliquent.
Le bruit empêche de voir l'essentiel. Selon le rapport State of Observability 2025 de Splunk, mené auprès de 1 855 professionnels de l'exploitation, 52 % des équipes font face à un volume élevé de fausses alertes et 59 % peinent avec des outils dispersés. Quand tout sonne, rien n'est prioritaire, et l'incident grave est vu trop tard.
Chaque minute compte. Selon PagerDuty (2026, 1 000 dirigeants métier et informatiques et développeurs, dans sept pays), plus des deux tiers des organisations perdent plus de 300 000 dollars par heure d'incident majeur, et 8 % plus d'un million. Nous avons détaillé le calcul de cette exposition dans notre analyse du coût d'une heure d'interruption de service.
La visibilité réduit le coût des incidents. Selon New Relic (2025), les organisations dotées d'une observabilité complète subissent des interruptions à fort impact qui coûtent en moyenne 1 million de dollars par heure, contre 2 millions pour les autres.
Ce que l'AIOps fait bien, et ce qu'elle ne fait pas
Ce qu'elle fait bien : réduire le nombre d'alertes à traiter, regrouper les signaux d'un même incident, indiquer les services et les clients touchés, accélérer la recherche de la cause, rédiger un premier résumé pour les équipes et la direction. Selon Gartner, dans les cas extrêmes, la réduction peut dépasser 95 % des événements qui demandaient une intervention humaine.
Ce qu'elle ne fait pas : elle ne corrige pas une supervision incomplète. Si un service critique n'est pas surveillé, aucune IA ne verra sa panne. Elle ne comprend pas non plus l'organisation : sans une cartographie à jour des services et de leurs dépendances, elle ne sait pas qu'une alerte sur un serveur concerne le paiement en ligne. Enfin, elle ne remplace pas la décision : les organisations interrogées par PagerDuty gardent un humain dans la boucle pour corriger les systèmes exposés aux clients (44 %), coordonner la réponse entre équipes (43 %) et communiquer sur l'incident (42 %).
Cinq niveaux de maturité
L'AIOps ne s'achète pas en une fois. Elle se construit par niveaux, chacun reposant sur le précédent.
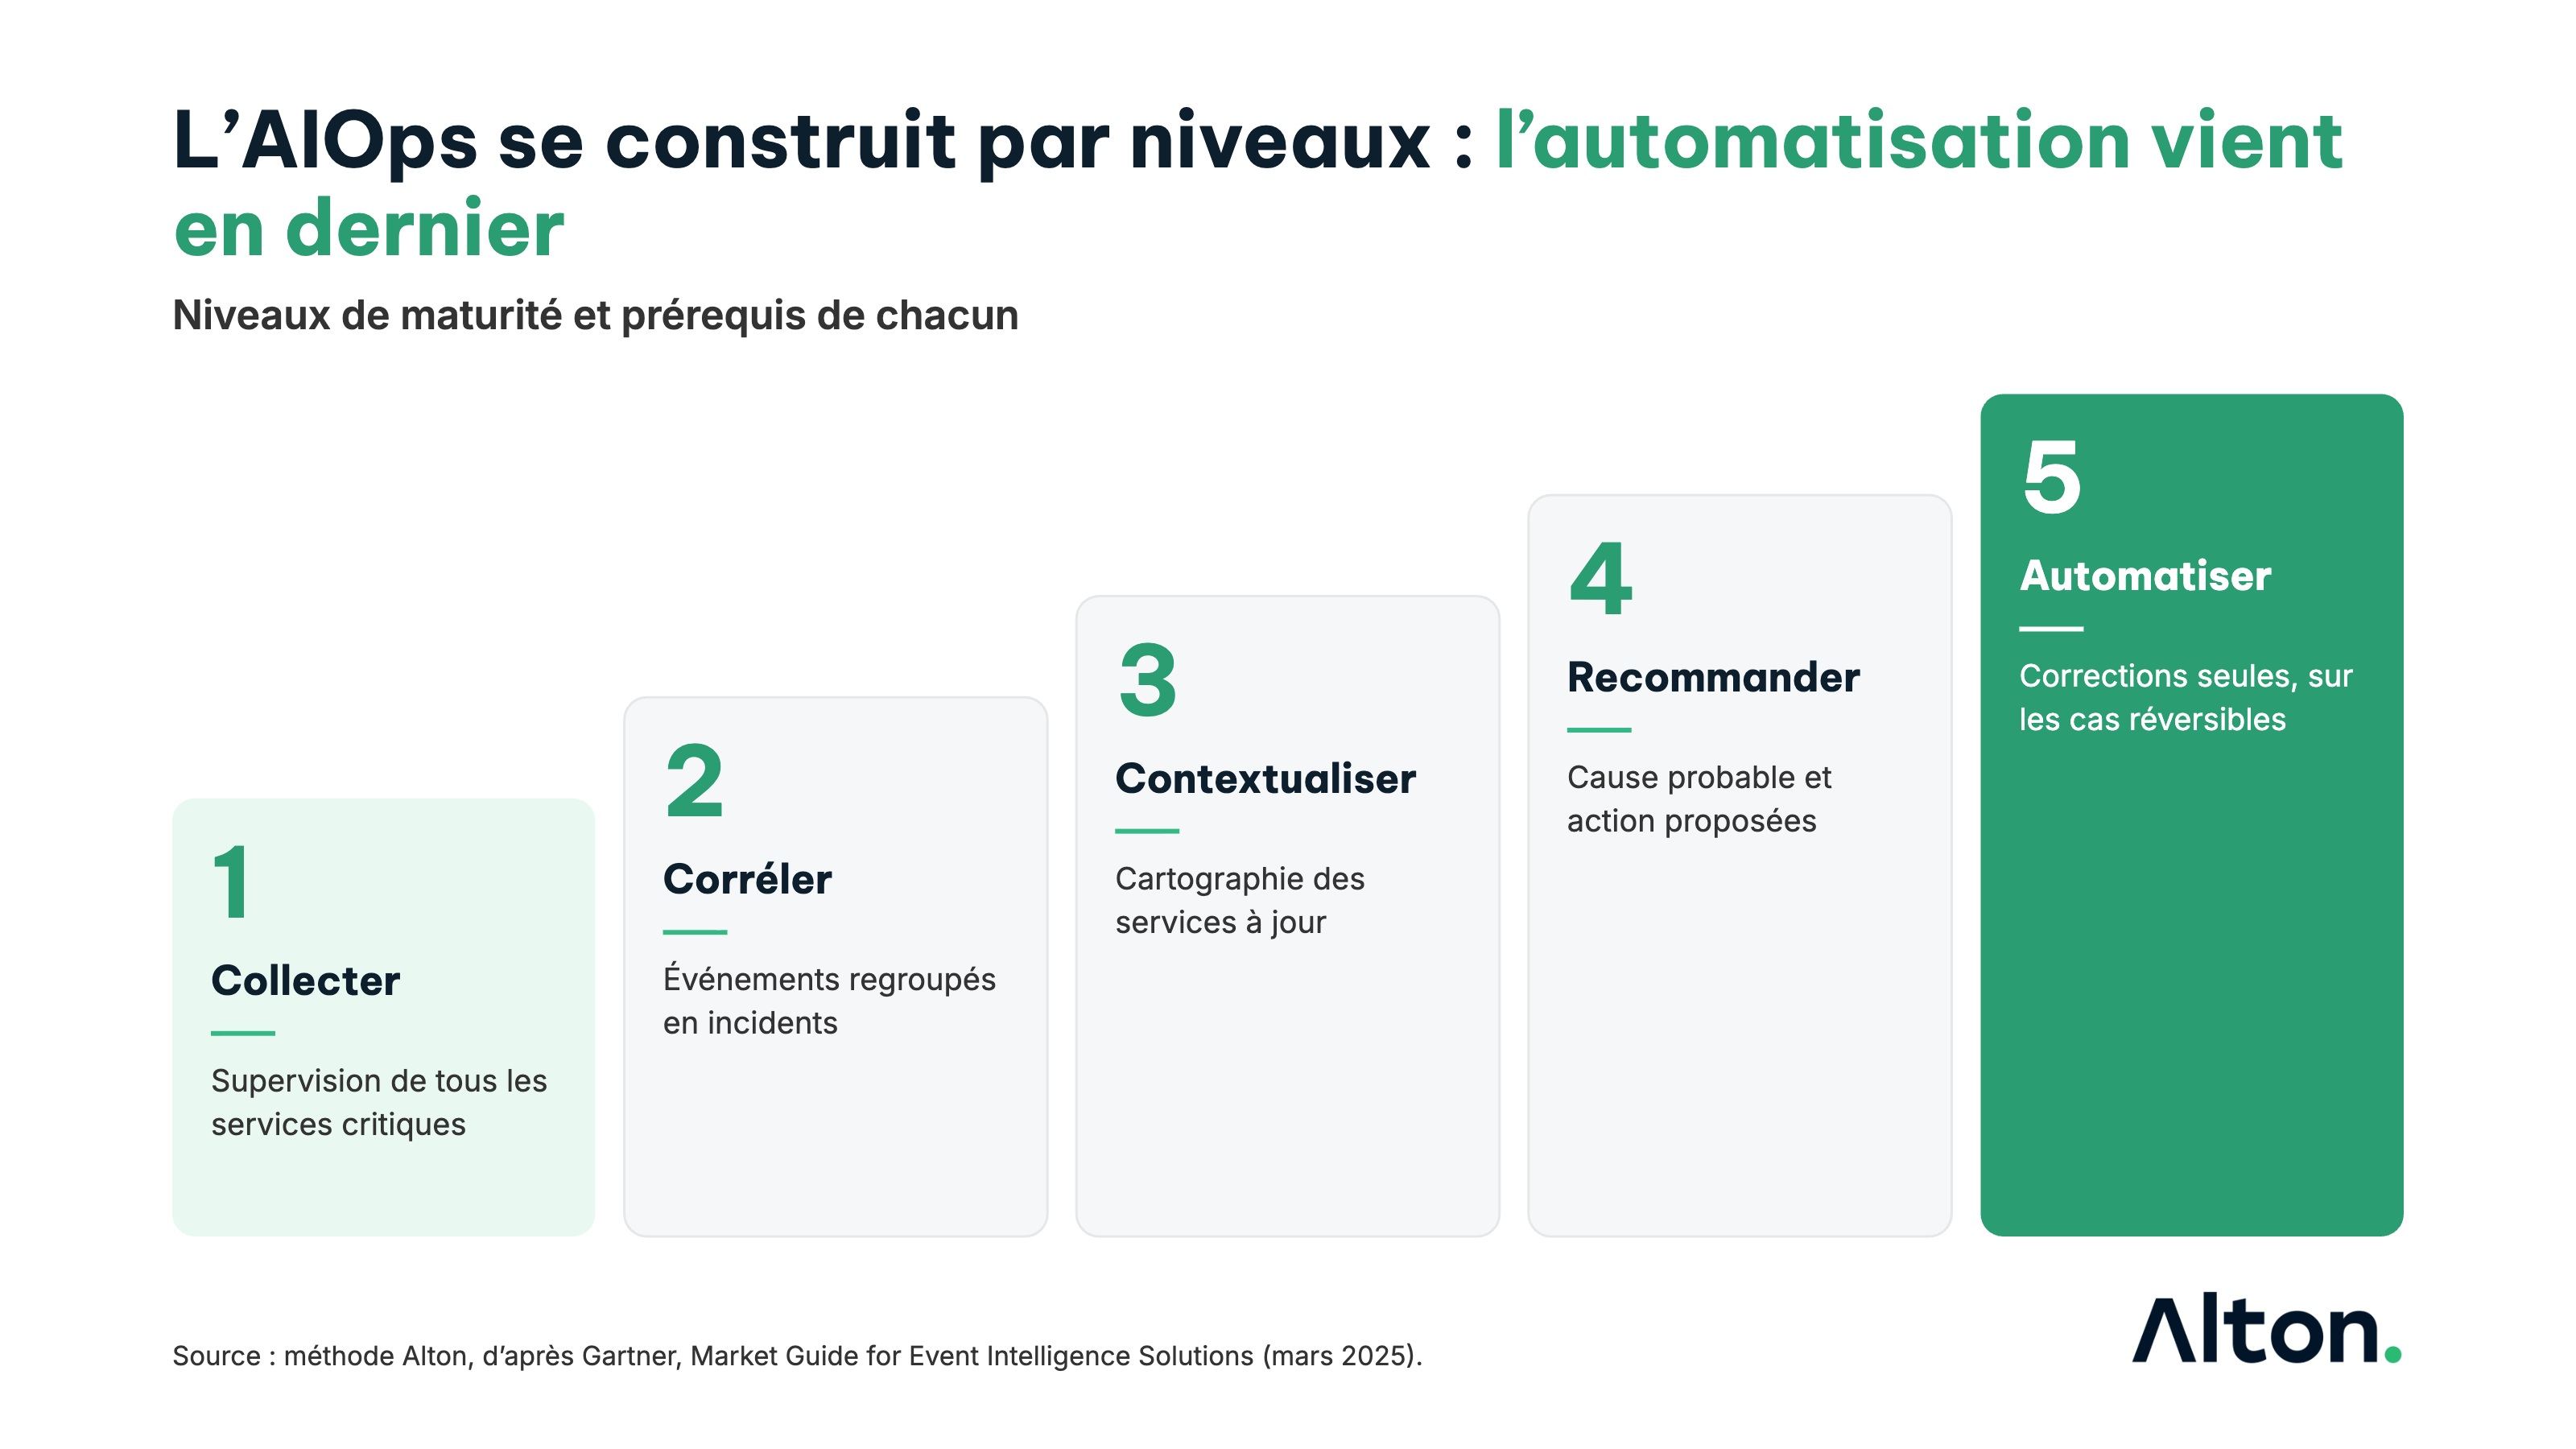
1. Collecter. Tous les services critiques sont supervisés, et les événements de tous les outils arrivent au même endroit. C'est le prérequis, et souvent le premier chantier.
2. Corréler. Les événements liés sont regroupés en un seul incident. C'est là que se gagne l'essentiel de la réduction du bruit.
3. Contextualiser. Chaque incident est rattaché au service métier touché, à son responsable et à sa priorité. Cela suppose une cartographie des services et une base de configuration fiables.
4. Recommander. L'outil propose une cause probable, des incidents similaires passés et une action. L'humain décide.
5. Automatiser. Certaines corrections sont déclenchées sans intervention : redémarrer un service, augmenter une capacité, basculer vers un site de secours. On les réserve aux actions réversibles et bien connues, selon la même logique que celle exposée dans notre article sur l'automatisation des processus avec l'IA.
Quatre indicateurs pour mesurer le résultat
Un projet AIOps doit être jugé sur des indicateurs mesurés avant et après :
- le taux de réduction du bruit : part des alertes brutes qui n'atteignent plus un humain ;
- le temps moyen de détection : délai entre le début d'un incident et sa prise en charge ;
- le temps moyen de rétablissement : délai entre la détection et le retour du service ;
- la part des incidents détectés avant les clients, qui dit si la supervision voit ce que vivent les utilisateurs.
Un exemple d'application
Exemple fictif, à titre d'illustration. Une banque de détail reçoit chaque mois environ 120 000 alertes de ses outils de supervision. Ses équipes en traitent manuellement une petite partie, et près d'un incident majeur sur deux est signalé d'abord par les clients ou les agences.
Elle commence par regrouper toutes les alertes dans une même plateforme et par compléter la supervision de ses trois services les plus critiques : virement, carte et banque en ligne. Elle active ensuite la corrélation, puis rattache chaque incident à sa cartographie des services. Au bout de six mois, le nombre d'incidents à traiter a fortement baissé et la majorité des incidents majeurs est détectée avant les clients. Elle n'automatise que deux corrections simples et réversibles, et garde la décision humaine pour tout le reste.
Ce que cela change pour une organisation marocaine
Les banques, les assurances, les opérateurs de télécommunications et les grandes administrations marocaines exploitent des systèmes de plus en plus hybrides : centres de données, cloud, applications mobiles, partenaires. Leurs outils de supervision se sont souvent ajoutés les uns aux autres, au fil des projets.
Deux recommandations. D'abord, commencer par un état des lieux de la supervision existante (couverture des services critiques, nombre d'outils, volume d'alertes, qualité de la cartographie) avant de choisir une plateforme. Ensuite, traiter l'AIOps comme un projet d'organisation autant que de technologie : rôles, procédures de gestion des incidents et règles d'automatisation doivent être définis, par exemple dans le cadre des pratiques ITIL.
Transparence : Alton intègre plusieurs technologies de supervision, dont Zabbix, Dynatrace et SolarWinds. Cet article ne recommande aucun éditeur en particulier.
Questions fréquentes
Qu'est-ce que l'AIOps en termes simples ? C'est l'usage de l'intelligence artificielle pour trier, regrouper et analyser les alertes de supervision, afin d'aider les équipes à détecter les incidents, à en trouver la cause et, dans certains cas, à les corriger automatiquement.
Quelle différence entre supervision, observabilité et AIOps ? La supervision surveille des indicateurs connus. L'observabilité permet de comprendre l'état d'un système à partir de ses données (métriques, journaux, traces). L'AIOps exploite ces données avec l'IA pour réduire le bruit, corréler et accélérer la réponse.
L'AIOps remplace-t-elle les équipes d'exploitation ? Non. Elle réduit le travail répétitif et accélère l'analyse. Les décisions sur les systèmes critiques, la coordination et la communication restent humaines dans la grande majorité des organisations.
Quels prérequis avant de lancer un projet AIOps ? Une supervision qui couvre les services critiques, des événements centralisés, une cartographie des services et de leurs dépendances à jour, et des procédures de gestion des incidents définies.
Comment mesurer le retour sur investissement de l'AIOps ? En suivant, avant et après, le taux de réduction du bruit, le temps moyen de détection, le temps moyen de rétablissement et la part des incidents détectés avant les clients, puis en valorisant les heures d'interruption évitées.
Ce qu'il faut retenir
L'AIOps tient ses promesses quand on lui demande d'abord de réduire le bruit et d'accélérer la compréhension des incidents, et seulement ensuite d'agir seule. Les organisations qui en tirent un résultat ont commencé par organiser leur supervision, mesurent leurs indicateurs et décident explicitement de ce que la machine a le droit de corriger.
Alton accompagne les organisations sur la transformation de la gestion des services et la résilience de leurs processus et de leurs applications, de l'état des lieux de la supervision à l'intégration des outils.
Sources
- Gartner, Market Guide for Event Intelligence Solutions, M. Crossley et G. Siegfried, 10 mars 2025 — https://www.gartner.com/en/documents/6250551
- Selector, Key Takeaways From the 2025 Gartner Market Guide for Event Intelligence Solutions, 6 février 2026 — https://www.selector.ai/blog/key-takeaways-from-the-2025-gartner-market-guide-for-event-intelligence-solutions/
- Splunk, State of Observability 2025, communiqué du 21 octobre 2025 — https://newsroom.cisco.com/c/r/newsroom/en/us/a/y2025/m10/splunk-report-shows-observability-is-a-business-catalyst-for-ai-adoption-customer-experience-and-product-innovation.html
- PagerDuty, 2026 State of AI-First Operations Report, 17 mars 2026 — https://www.pagerduty.com/blog/digital-operations/2026-state-of-ai-first-operations-report/
- New Relic, New Relic Study Reveals Businesses Face an Annual Median Cost of $76 Million from High-Impact IT Outages, 17 septembre 2025 — https://newrelic.com/press-release/20250917