Catégoriser, prioriser et affecter un ticket sont des décisions courtes, répétées des milliers de fois par mois, que l'on confie de plus en plus à des modèles conçus pour rédiger. Jev, le modèle de décision publié par TypeSafe AI le 15 septembre 2026, montre qu'un autre outil existe pour ce travail, et surtout que la qualité du tri dépend d'abord de la façon dont on pose les questions.
En bref
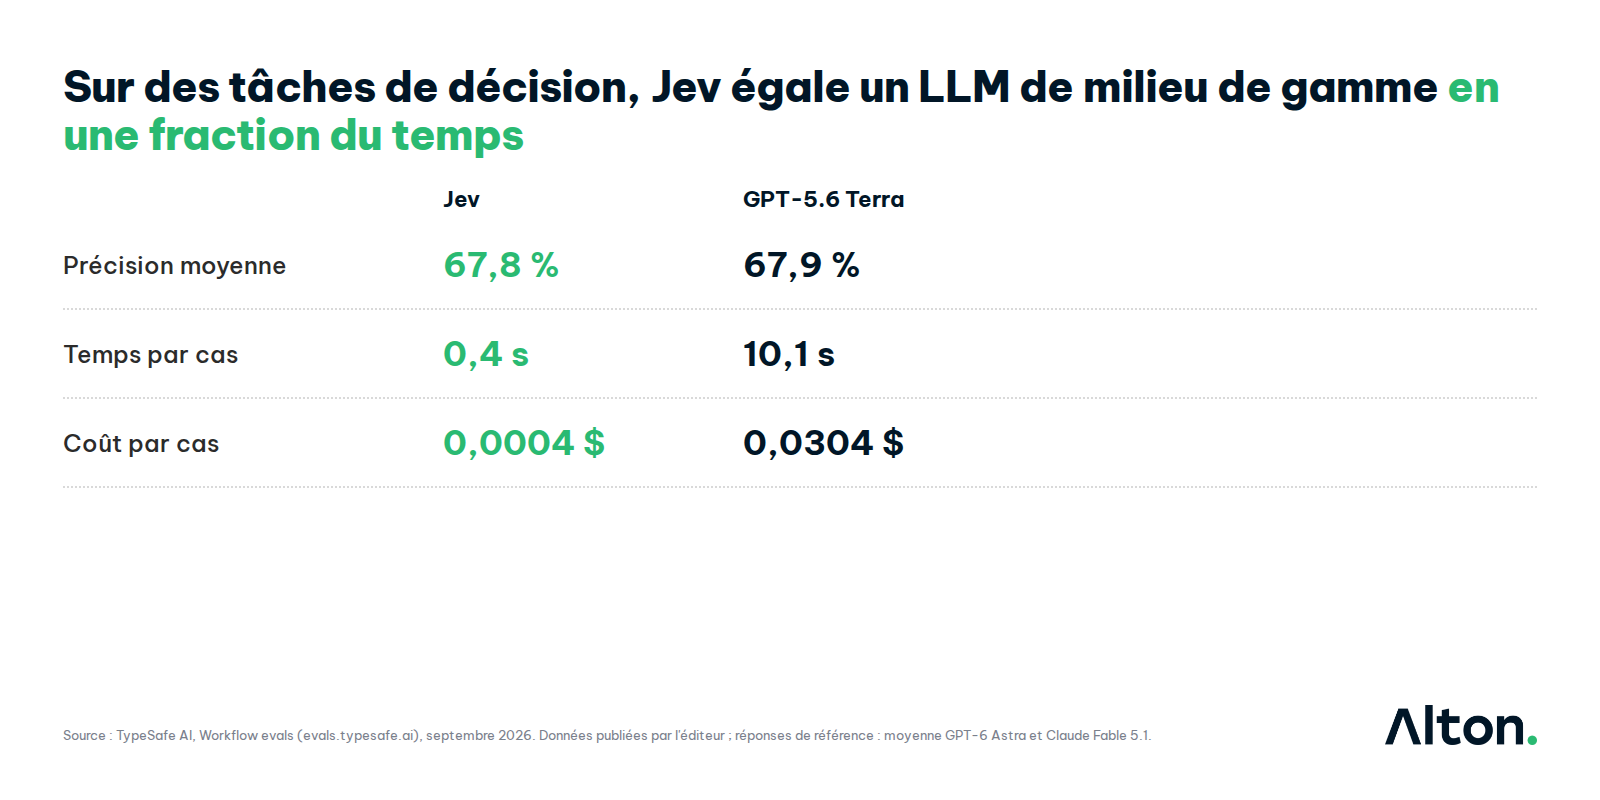
Jev est un modèle d'IA qui ne produit pas de texte : il reçoit un contexte et des questions fermées, puis renvoie des décisions typées (un choix, un score ou une probabilité) accompagnées d'un niveau de confiance. Sur les quatre workflows publiés par son éditeur, il atteint 67,8 % de précision, au niveau de GPT-5.6 Terra (67,9 %), pour 0,4 seconde et 0,0004 dollar par cas, contre 10,1 secondes et 0,0304 dollar. Pour un centre de services, il convient à la catégorisation, à l'évaluation de l'urgence et de l'impact et à la détection de doublons, pas à la rédaction des réponses. Les mêmes données montrent qu'un découpage de la décision en questions courtes améliore aussi la précision de tous les LLM testés : c'est le premier chantier, quel que soit le modèle retenu.
Jev renvoie une décision, pas un texte
Un LLM produit une suite de mots, que le logiciel doit ensuite analyser pour en extraire une catégorie ou une priorité. Jev inverse la logique : on lui envoie un « état » (le texte du ticket, l'entité, le demandeur, l'historique utile) et une liste de questions dont les réponses possibles sont définies à l'avance. TypeSafe propose trois types de questions : Choice pour choisir une option dans une liste, Score pour situer un élément sur une échelle, Noul pour une probabilité de oui ou de non. Toutes les questions sont traitées en un seul appel, en parallèle.
Chaque réponse arrive avec une probabilité que l'éditeur dit calibrée : une confiance élevée doit correspondre à une précision élevée. C'est ce point qui intéresse un responsable de centre de services, car il permet de fixer un seuil au-dessus duquel le logiciel agit seul, et en dessous duquel un technicien reprend la main.
Deux précisions évitent les malentendus. D'abord, l'affirmation « Jev ne peut pas halluciner » signifie que sa sortie respecte toujours le format prévu : la catégorie renvoyée existe dans votre liste. Elle ne garantit pas que ce soit la bonne catégorie. Ensuite, Jev donne un chiffre, pas une justification écrite, ce qui compte pour l'audit d'une décision.
Côté conditions, TypeSafe affiche 0,042 dollar par million de tokens en entrée, sans facturation de la sortie, et une latence de 70 à 500 millisecondes. Le modèle accepte jusqu'à 255 options pour une question à choix, ce qui couvre la plupart des catalogues de catégories. Il est en accès anticipé depuis le 15 septembre 2026, via l'API de TypeSafe et plusieurs plateformes tierces (OpenRouter, Cloudflare Workers AI, DigitalOcean, Vercel AI Gateway).
Ce que disent les chiffres de l'éditeur, et ce qu'ils ne disent pas
TypeSafe a publié une évaluation sur quatre workflows d'automatisation : alertes de sécurité, contrôle de traces d'agents, traitement de factures et service client. Les réponses de référence sont la moyenne de deux modèles haut de gamme, GPT-6 Astra et Claude Fable 5.1.
| Modèle | Précision moyenne | Coût par cas | Temps par cas |
|---|---|---|---|
| Jev | 67,8 % | 0,0004 $ | 0,4 s |
| GPT-5.6 Terra | 67,9 % | 0,0304 $ | 10,1 s |
| GPT-5.6 Sol | 74,1 % | 0,0836 $ | 23,3 s |
| Claude Opus 5 | 73,1 % | 0,1761 $ | 37,8 s |
Source : TypeSafe AI, Workflow evals, septembre 2026. Données publiées par l'éditeur.
Le résultat varie selon la tâche. Sur le service client, le cas le plus proche d'un centre de services, Jev obtient 76,0 %, au-dessus de GPT-5.6 Terra (72,7 %) et à deux points de GPT-5.6 Sol (78,3 %). Sur le traitement des factures, il tombe à 61,8 %, loin derrière Terra (74,7 %). Une moyenne flatteuse peut donc cacher un écart important sur votre propre cas.
TypeSafe reconnaît lui-même plusieurs limites : les workflows ont été écrits par son équipe, les mesures ont été faites depuis la côte ouest des États-Unis où se trouve son service, et il ne peut pas prouver que ses prix ne sont pas subventionnés. Aucun des quatre workflows n'est un tri de tickets ITSM. Ces chiffres justifient un test, pas un déploiement.
Découper la décision : le résultat le plus utile pour un DSI
La donnée la plus intéressante de cette évaluation ne concerne pas Jev. TypeSafe a comparé deux façons d'utiliser chaque modèle : une consigne unique qui décrit toute la politique, ou un workflow où la politique est découpée en questions courtes, la décision finale étant prise par le code. Tous les modèles font mieux avec le workflow.
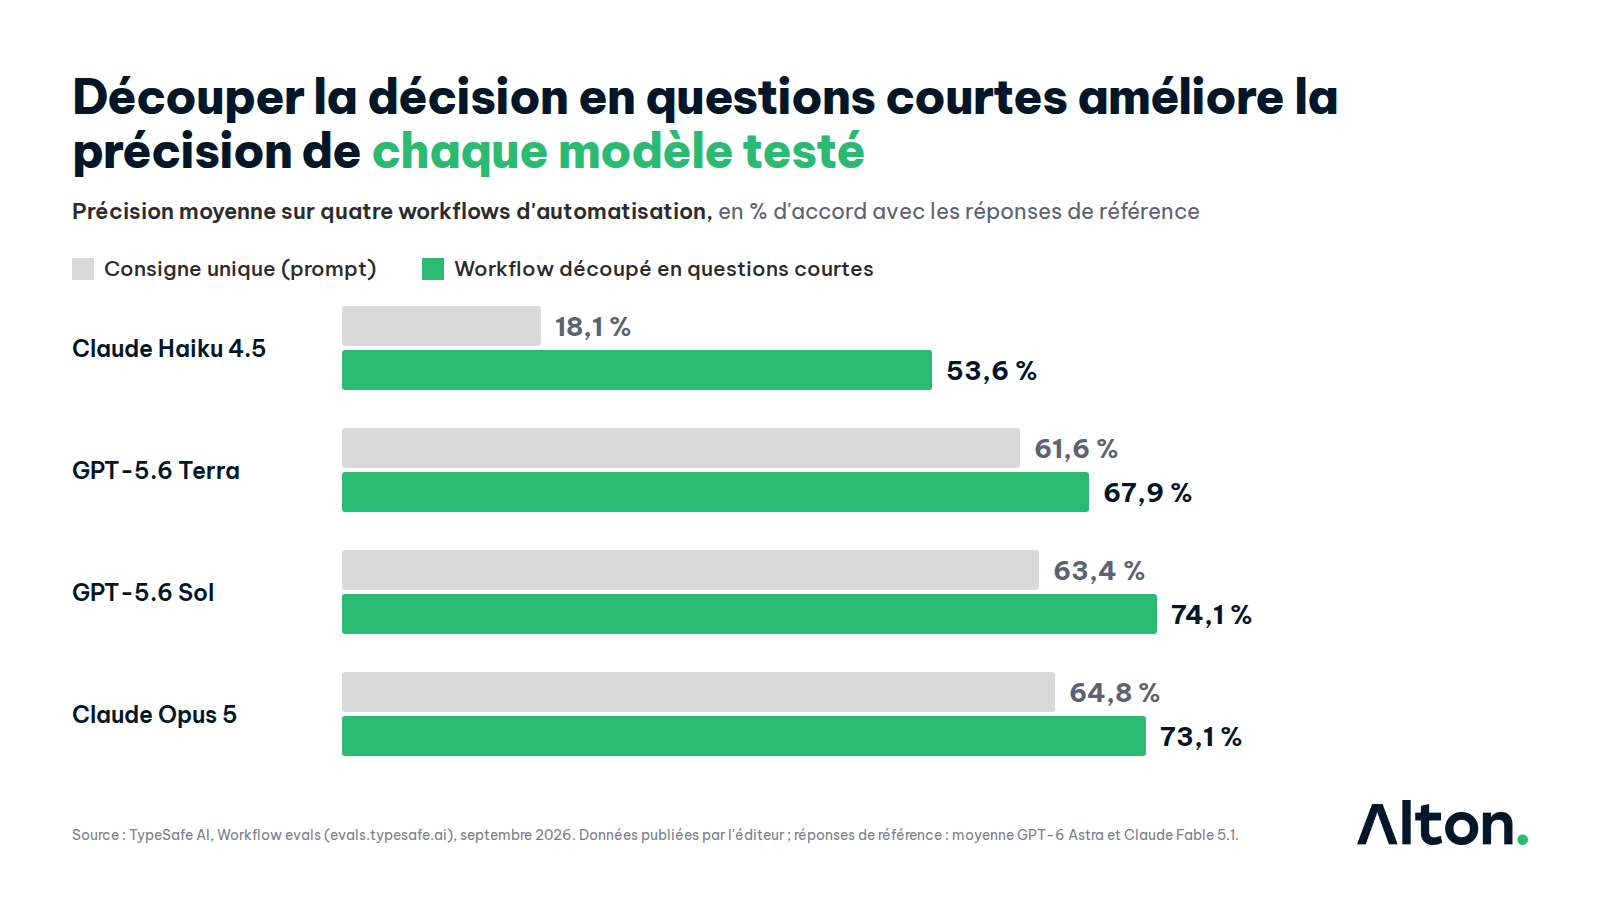
Pour un centre de services, ce découpage existe déjà : c'est la logique ITIL. La priorité d'un incident se déduit de son urgence et de son impact, et GLPI la calcule avec une matrice urgence × impact configurable. Il suffit donc de demander au modèle d'évaluer l'urgence et l'impact, et de laisser GLPI appliquer la matrice.
L'erreur courante consiste à demander à un modèle « quelle est la priorité de ce ticket ? ». La question mélange un jugement (à quel point le service est dégradé) et une politique (ce que l'organisation considère comme prioritaire). Le résultat est moins précis, et personne ne peut expliquer après coup pourquoi un ticket est passé en P1.
Grille de décision : modèle de décision, LLM ou règle GLPI ?
| Étape du ticket | Nature de la décision | Qui décide |
|---|---|---|
| Incident ou demande | Choix entre deux options | Modèle de décision (Choice) |
| Catégorie ITIL | Choix dans le catalogue | Modèle de décision (Choice), si le catalogue est propre |
| Urgence, impact | Position sur une échelle | Modèle de décision (Score) |
| Priorité | Application d'une politique | Matrice de priorité GLPI |
| Groupe d'affectation | Politique liée à la catégorie et à l'entité | Règles métier GLPI ; modèle seulement si les règles deviennent ingérables |
| Doublon ou incident majeur | Probabilité oui / non | Modèle de décision (Noul), puis rapprochement par un technicien |
| Réponse à l'utilisateur, article de base de connaissances | Texte à rédiger | Technicien, ou LLM sous contrôle humain |
| Changement de statut, clôture, calcul des SLA | Règle de gestion | GLPI, jamais le modèle |
Quatre critères tranchent les cas limites. Le volume : un modèle de décision se justifie quand la même question se pose des centaines de fois par jour. Des réponses bornées : si la liste des réponses possibles ne peut pas être écrite à l'avance, c'est un travail de LLM. Le besoin de justification : une décision qui doit être expliquée par écrit à un auditeur ou à un usager relève d'un humain ou d'un LLM. La langue des tickets, enfin, traitée plus bas.
Mettre en place un tri avec seuil de confiance dans GLPI 11
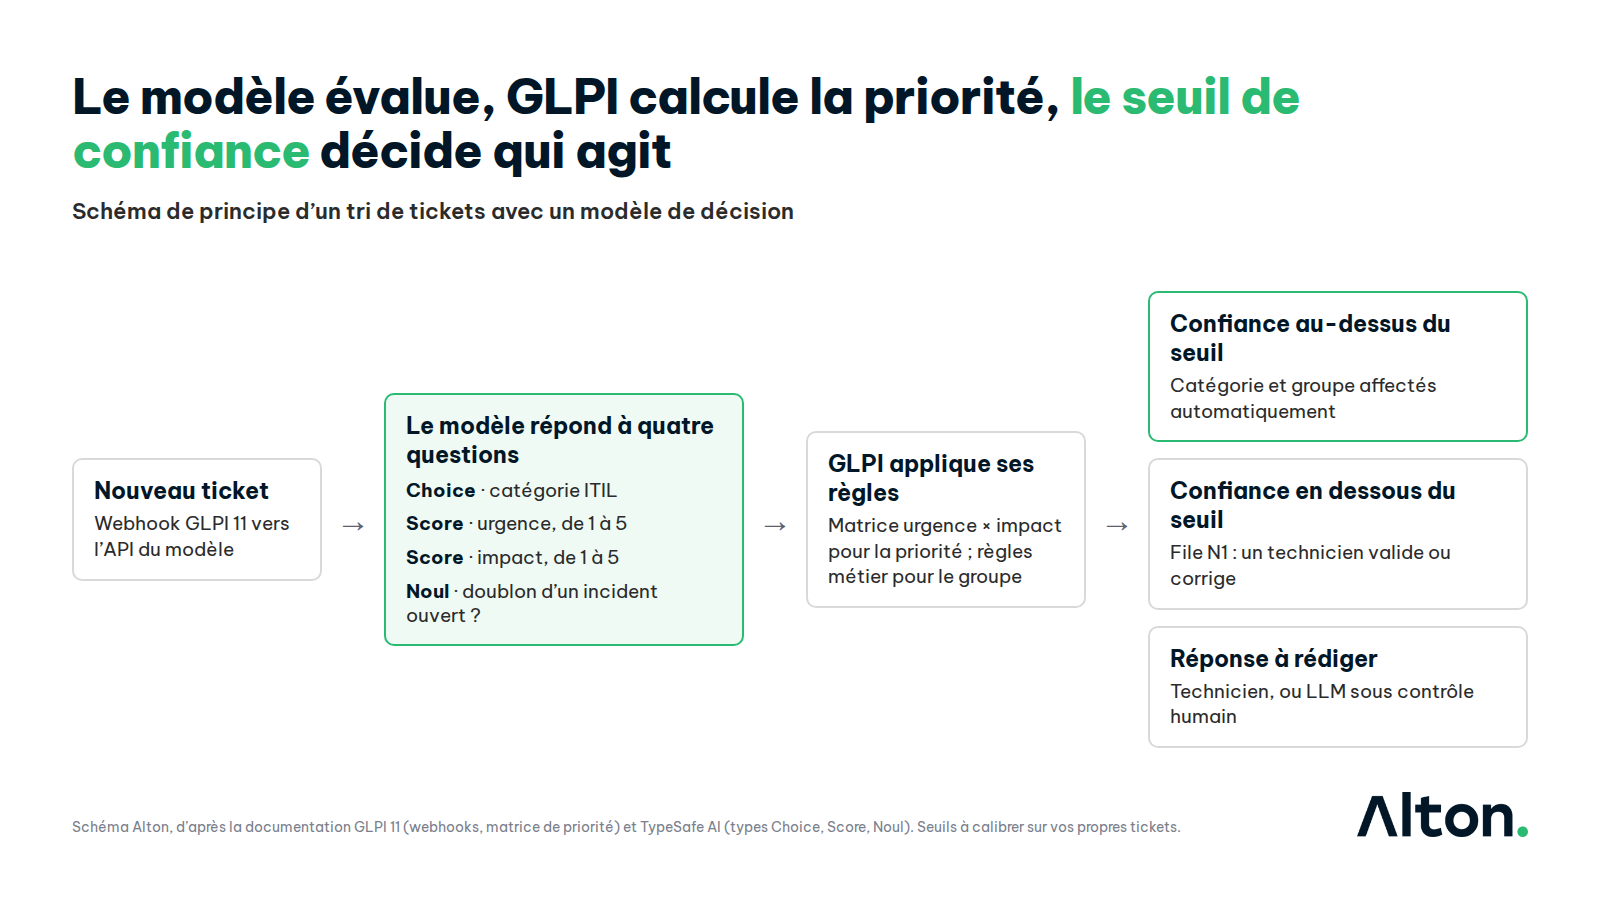
GLPI 11 apporte les deux briques techniques nécessaires : des webhooks déclenchés à la création d'un ticket, et une nouvelle API REST pour écrire en retour la catégorie, l'urgence et l'impact. La démarche se déroule en six étapes.
- Assainir le catalogue de catégories. Un modèle ne peut pas choisir correctement entre deux catégories qui se recouvrent. Fusionner les doublons et décrire chaque catégorie en une phrase, car cette description sert de consigne au modèle.
- Constituer un échantillon de référence. Extraire quelques centaines de tickets récents dont la catégorie, l'urgence et l'impact ont été vérifiés par un technicien expérimenté.
- Mesurer en mode observation. Le modèle propose, le technicien décide, et l'on compare pendant quelques semaines sans rien automatiser.
- Fixer un seuil par question. Le seuil acceptable pour la catégorie n'est pas celui de l'impact : une erreur d'impact sur un service critique coûte plus cher.
- Automatiser au-dessus du seuil seulement. Les tickets incertains restent en file N1, avec la proposition du modèle affichée pour gagner du temps.
- Suivre deux indicateurs. Le taux de tickets recatégorisés après affectation automatique et le taux de réaffectation entre groupes. S'ils remontent, le seuil ou le catalogue est à revoir.
Le cas marocain : langue, latence et données
La langue. Au Maroc, un même centre de services reçoit des tickets en français, en arabe, parfois en darija ou en mélange des trois. Un guide d'intégration publié en septembre 2026 indique que Jev est le plus précis en anglais et recommande de surveiller les niveaux de confiance dans les autres langues. L'échantillon de référence doit donc refléter la répartition réelle des langues de vos tickets.
La latence. Les temps annoncés ont été mesurés près des serveurs de TypeSafe, aux États-Unis. Depuis Rabat ou Casablanca, il faut ajouter le trajet réseau : à mesurer en mode observation. Pour un tri de tickets, une seconde reste sans effet sur le délai de prise en charge, mais le chiffre compte pour une décision appelée en boucle.
Les données. Un ticket contient souvent des données personnelles : nom, téléphone, poste, parfois des informations sur un usager. Les envoyer à une API hébergée hors du Maroc constitue un transfert de données à l'étranger au sens de la loi 09-08, soumis au cadre de la CNDP. Le régime applicable (déclaration ou autorisation) est à vérifier avec votre délégué à la protection des données ou votre juriste avant tout test sur des tickets réels. Dans tous les cas, le modèle n'a besoin que de la description du problème et du service concerné : retirer les noms et coordonnées de l'état envoyé réduit le risque sans dégrader le tri.
Ce que fait Alton sur ce sujet
Alton est partenaire Silver GLPI Network de Teclib' au Maroc. Nous intégrons GLPI et structurons les centres de services selon les pratiques ITIL : catalogue de catégories, matrice de priorité, règles d'affectation et indicateurs de suivi, c'est-à-dire la base sur laquelle un modèle de décision peut travailler sans dégrader la qualité du tri.
Sources
- TypeSafe AI, « Introducing System One Models & Jev », 15 septembre 2026. https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI, Workflow evals, septembre 2026. https://evals.typesafe.ai/
- TypeSafe AI, page d'accueil (seuils d'action autonome et d'escalade). https://typesafe.ai/
- Firecrawl, « What Is Jev? Inside TypeSafe's Decision-Only AI Model », septembre 2026 (ouverture des inscriptions, plateformes d'accès). https://www.firecrawl.dev/blog/what-is-jev
- AnythingMCP, « Triage Support Tickets with Jev in Claude », septembre 2026 (précision selon la langue). https://anythingmcp.com/guides/triage-support-tickets-with-jev
- La Refonte, « Jev (TypeSafe) : le modèle IA qui décide sans texte », septembre 2026 (disponibilité sur Cloudflare Workers AI). https://www.la-refonte.fr/blog/jev-modele-decision-ia
- GLPI, documentation développeur, High-Level API (GLPI 11). https://glpi-developer-documentation.readthedocs.io/en/master/devapi/hlapi/index.html
- IT-Connect, « Découvrez les principales nouveautés de GLPI 11 » (webhooks, nouvelle API REST). https://www.it-connect.fr/decouvrez-les-principales-nouveautes-de-glpi-11/
- Loi n° 09-08 relative à la protection des personnes physiques à l'égard du traitement des données à caractère personnel, CNDP (régime des transferts à l'étranger : à vérifier). https://www.cndp.ma