Un serveur GPU se commande souvent d'après la taille du modèle d'IA, puis sature à l'ouverture aux utilisateurs ou tourne à moitié vide. Cet article donne la méthode de calcul pas à pas, avec ses formules, un exemple chiffré et la répartition des décisions entre direction générale, métiers et DSI.
En bref
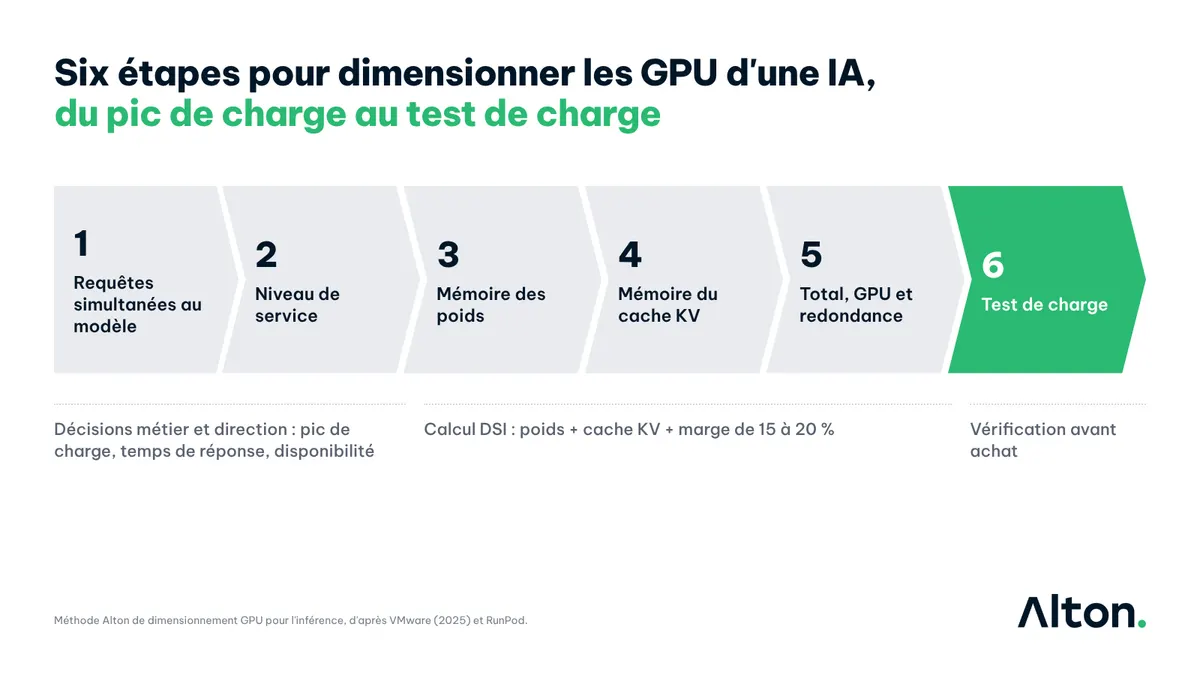
Dimensionner les GPU d'une IA générative se fait en six étapes. On traduit d'abord l'usage en requêtes simultanées adressées au modèle, puis on fixe le niveau de service : temps de réponse et disponibilité. On calcule ensuite la mémoire des poids du modèle, puis celle du cache de contexte (cache KV), qui dépend des requêtes simultanées et de la longueur des documents. On additionne, on ajoute 15 à 20 % de marge, on convertit en nombre de GPU et on prévoit la redondance. Enfin, un test de charge confirme le calcul avant tout achat.
Étape 1 : traduire l'usage en requêtes simultanées au modèle
Le premier chiffre à établir n'est pas le nombre d'utilisateurs, mais le nombre de requêtes que le modèle traite au même instant. Un utilisateur connecté lit, réfléchit et tape : il n'occupe le modèle que pendant la génération de la réponse.
La formule tient en une ligne : requêtes simultanées = requêtes par seconde à l'heure de pointe × durée moyenne de traitement d'une requête, en secondes.
Exemple : un assistant interne reçoit 3 600 questions pendant son heure la plus chargée, soit une par seconde. Chaque réponse fait environ 400 tokens, générés à 25 tokens par seconde, soit 16 secondes. Le modèle traite donc environ 16 requêtes en même temps, quel que soit le nombre de collaborateurs connectés.
Deux corrections s'appliquent. Les questions traitées par une FAQ ou un moteur d'intentions, sans appel au modèle, sortent du calcul. À l'inverse, un agent IA qui enchaîne plusieurs appels pour une seule demande multiplie la charge d'autant.
Qui tranche : la direction métier fournit l'usage et le pic ; la DSI le convertit en requêtes simultanées.
Étape 2 : fixer le niveau de service
Trois engagements se décident ici, comme pour tout service inscrit au catalogue : le délai avant le premier mot de la réponse, la vitesse d'affichage par utilisateur (en tokens par seconde) et la disponibilité attendue.
Les deux premiers déterminent la durée de traitement utilisée à l'étape 1 et la puissance à prévoir. Le troisième décide de la redondance : un service qui doit survivre à la panne d'un serveur demande une seconde instance ou une capacité de secours, ce qui peut doubler la ligne matériel.
Qui tranche : la direction générale et la DSI, car ce choix engage le budget.
Étape 3 : calculer la mémoire des poids du modèle
Le modèle est chargé en entier dans la mémoire des GPU. Sa taille se calcule ainsi : nombre de paramètres × octets par paramètre. Un paramètre occupe 2 octets en 16 bits, 1 octet en 8 bits et 0,5 octet en 4 bits.
Un modèle de 70 milliards de paramètres occupe donc 140 Go en 16 bits, 70 Go en 8 bits et 35 Go en 4 bits. Réduire la précision (la quantification) libère de la mémoire, mais son effet sur la qualité des réponses se vérifie sur des cas métier réels.
Le choix du modèle se fait dans le même ordre : on retient le plus petit modèle qui donne une qualité suffisante sur un jeu de questions représentatives. Pour une tâche ciblée, un modèle de 8 milliards de paramètres peut suffire et réduit la mémoire des poids d'un facteur proche de neuf.
Qui tranche : la DSI, sur la base de tests de qualité validés par le métier.
Étape 4 : calculer le cache KV, la part variable
Le cache KV conserve, pour chaque requête en cours, le contexte déjà lu par le modèle : la question, l'historique et les documents fournis. C'est le poste que les estimations rapides oublient, et celui qui varie le plus.
Sa taille par token dépend de l'architecture du modèle : 2 × nombre de couches × nombre de têtes clé-valeur × dimension d'une tête × octets par valeur. Pour un modèle de type Llama 3.1 70B (80 couches, 8 têtes clé-valeur, dimension 128), en 16 bits, on obtient environ 0,33 Mo par token.
On multiplie ensuite par la longueur du contexte et par le nombre de requêtes simultanées. Avec 8 192 tokens de contexte (quelques dizaines de pages) et 16 requêtes, le cache atteint 43 Go. Avec 64 requêtes, il atteint 172 Go, soit plus du double des poids du modèle. VMware décrit le même calcul dans son guide de dimensionnement pour l'inférence.
Qui tranche : le métier et la DSI, sur la longueur des documents et des conversations à accepter.
Étape 5 : additionner, convertir en GPU, prévoir la redondance
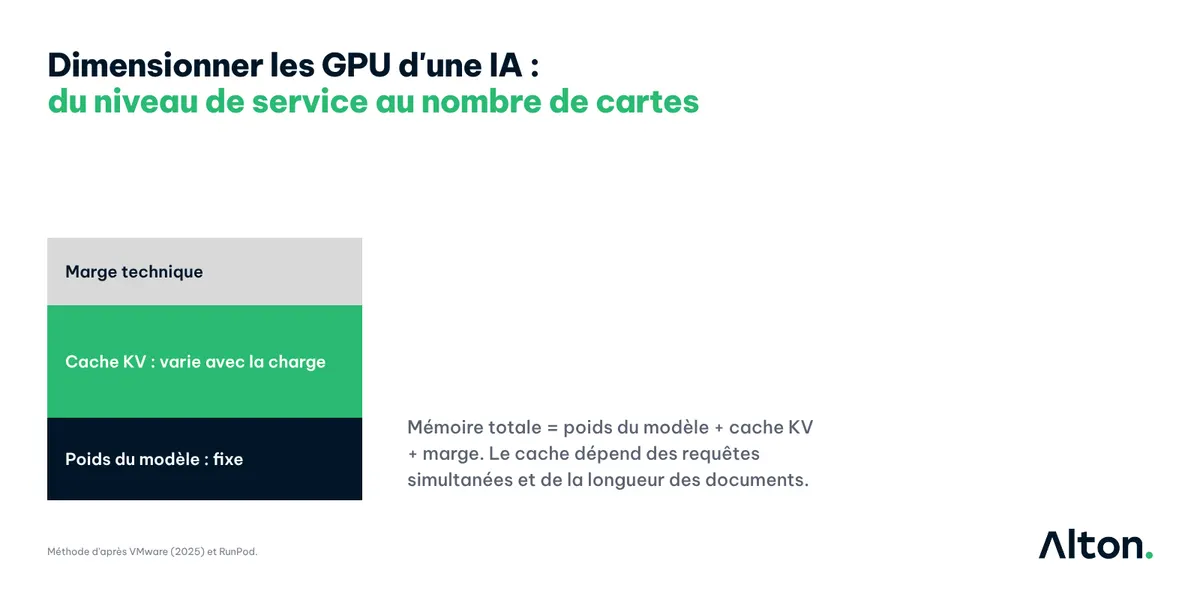
Mémoire totale = poids + cache KV, plus une marge de 15 à 20 % pour les calculs intermédiaires, le moteur d'inférence et le contexte logiciel (RunPod). On divise ensuite par la mémoire d'un GPU, puis on arrondit au nombre de cartes que le serveur sait répartir.
| Requêtes traitées en même temps | Poids (8 bits) | Cache KV | Marge (20 %) | Mémoire totale | GPU de 80 Go |
|---|---|---|---|---|---|
| 16 | 70 Go | 43 Go | 23 Go | 136 Go | 2 |
| 64 | 70 Go | 172 Go | 48 Go | 290 Go | 4 |
Exemple illustratif, calculé par Alton selon la méthode ci-dessus ; ce n'est pas un projet client.
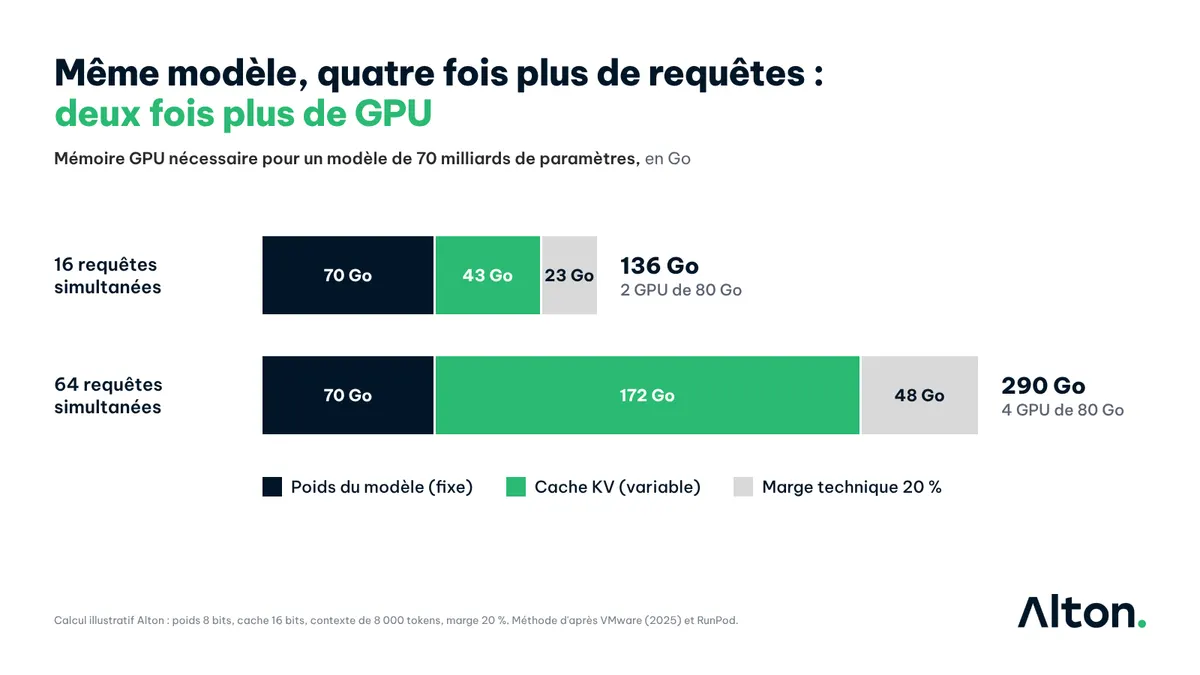
Le modèle est identique dans les deux lignes. Quadrupler la simultanéité double le nombre de GPU. Si la disponibilité fixée à l'étape 2 exige une seconde instance, il faut encore doubler.
La mémoire dit si le service tient ; elle ne dit pas s'il répond vite. Pendant la génération, le GPU relit les poids et le cache à chaque token produit : la bande passante mémoire de la carte fixe donc la vitesse d'affichage. À mémoire égale, la carte la plus rapide en bande passante répond plus vite.
Étape 6 : vérifier par un test de charge avant d'acheter
Le calcul donne un ordre de grandeur, le test de charge le confirme. Il consiste à envoyer des requêtes représentatives (mêmes longueurs de question, de document et de réponse) en augmentant progressivement la simultanéité.
On mesure quatre valeurs : le délai avant le premier mot, la vitesse par utilisateur, le débit total et le taux d'erreur. Le bon dimensionnement est le point où les engagements de l'étape 2 sont tenus au pic de l'étape 1. Le test se fait sur des GPU loués quelques heures ou sur un environnement de démonstration du fournisseur, avant la commande.
Le choix du moteur d'inférence entre aussi dans ce test. Les chercheurs de l'université de Berkeley à l'origine de vLLM ont mesuré en 2023 que les moteurs de l'époque gaspillaient 60 à 80 % de la mémoire réservée au cache, faute d'allocation fine. Le même matériel n'offre pas la même capacité selon le logiciel qui le pilote.
Quatre erreurs de calcul que nous rencontrons
Compter les utilisateurs au lieu des requêtes. Un cahier des charges qui annonce « plusieurs milliers d'utilisateurs simultanés » ne dit rien du nombre d'appels au modèle. Sans l'étape 1, le dimensionnement est surestimé d'un ou deux ordres de grandeur.
Dimensionner sur les poids seuls. Le modèle tient dans la carte, le service démarre, puis refuse les requêtes dès que les conversations s'allongent. C'est le cache KV qui manquait.
Transposer un résultat de banc d'essai. Un chiffre publié par un constructeur vaut pour ses longueurs de question et de réponse. Il ne vaut pas pour les vôtres sans test.
Oublier la redondance. Un serveur dont tous les GPU servent à charger le modèle ne survit pas à la perte d'une carte.
Après le calcul : héberger et suivre l'utilisation
Le calcul ne dépend pas de l'hébergement, mais il éclaire le choix. Une charge stable et des données sensibles orientent vers un serveur acquis ou hébergé ; une charge variable vers des GPU loués ; une demande faible ou incertaine vers l'API d'un fournisseur de modèles. Au Maroc, les traitements de données personnelles relèvent de la loi 09-08 et du contrôle de la CNDP ; l'envoi de données vers un fournisseur hors du pays s'examine au cas par cas avec votre DPO.
Une fois en production, l'utilisation des GPU se mesure comme un taux de respect des SLA. C'est rarement fait : en juillet 2026, 69 % des entreprises qui exploitent leurs propres GPU déclaraient une utilisation de 50 % ou moins, et 12 % ne la mesuraient pas (VentureBeat Pulse Research, 2026). Ce suivi permet de corriger le dimensionnement à chaque nouvel usage, plutôt que d'ajouter des cartes.
Ce qu'Alton fait sur ce sujet
Alton est un cabinet de conseil basé à Rabat, spécialisé dans la structuration des centres de services informatiques et l'intégration d'outils ITSM, avec une activité IA & Digitalisation. Nous appliquons cette méthode au cadrage technique des projets d'IA, du niveau de service jusqu'au test de charge.
Nous avons développé un outil de dimensionnement qui applique cette méthode. Pour en savoir plus, contactez Alton au +212 6 61 46 06 89 ou sur altongroup.net.
Sources
- VMware (Broadcom), « LLM Inference Sizing and Performance Guidance », 25 septembre 2024, mis à jour le 4 août 2025. https://blogs.vmware.com/cloud-foundation/2024/09/25/llm-inference-sizing-and-performance-guidance/
- RunPod, « GPU Memory Sizing Guide for LLM Inference ». https://www.runpod.io/articles/guides/gpu-memory-sizing-guide-for-llm-inference
- Kwon W. et al. (UC Berkeley), « Efficient Memory Management for Large Language Model Serving with PagedAttention », SOSP 2023. https://arxiv.org/abs/2309.06180
- vLLM, « vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention », 20 juin 2023. https://vllm.ai/blog/2023-06-20-vllm
- VentureBeat Pulse Research, « Infrastructure and compute: Enterprises are buying AI compute for speed while flying blind on what it costs », 12 août 2026 (vague de juillet 2026, n = 170). https://venturebeat.com/resources/infrastructure-and-compute-enterprises-are-buying-ai-compute-for-speed-while-flying-blind-on-what-it-costs
- Towards Data Science, « The KV Cache Tax: Why Inference Servers Run Out of Memory Before Compute », 16 septembre 2026 (architecture de Llama 3.1 70B : 80 couches, 8 têtes clé-valeur, dimension 128, environ 320 Ko de cache par token en 16 bits). https://towardsdatascience.com/the-kv-cache-tax-why-inference-servers-run-out-of-memory-before-compute/